METR: Zeithorizont von Frontier-KI verdoppelt sich auf schwererem Aufgabenset etwa alle 3,6 Monate
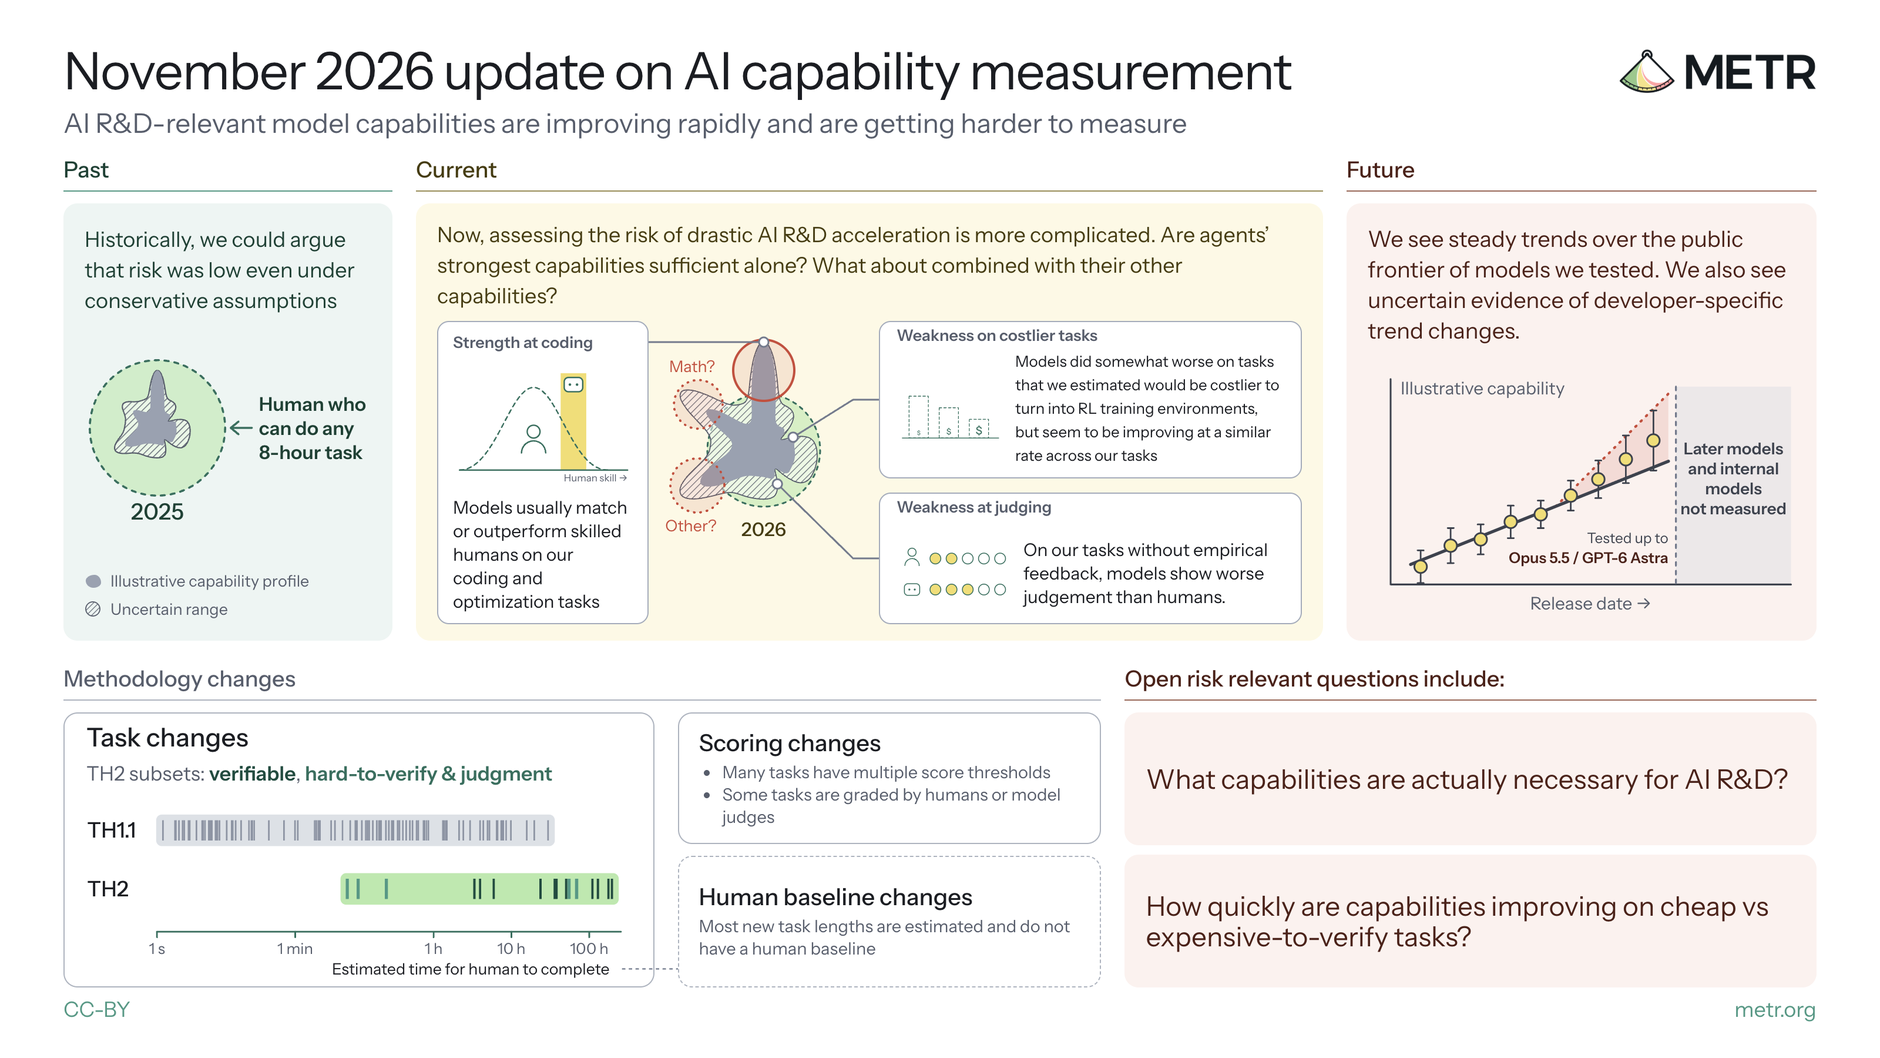
Das Q4-Update zu Modellen bis Opus 5.5 und GPT-6 Astra sagt, Agenten erreichen oder übertreffen qualifizierte Menschen bei Programmierung und Optimierung, urteilen aber schlechter als Experten ohne klares Feedback, und öffentliche Daten können eine drastische Beschleunigung der KI-Forschung in den nächsten Jahren nicht ausschließen.
Warum es wichtig ist
METRs Zeithorizont-Grafik ist eines der meistzitierten Maße für KI-Fortschritt; das Update fügt mit TH2 ein schwereres Set unschärferer, urteilsintensiver Aufgaben hinzu, die näher an KI-Forschung liegen. Laut MIT Technology Review hielt das METR-Team keine der von Modellen entworfenen Evaluierungen für nützlich. Die Verdopplungszeit ähnelt einem Trend, den OpenAI für interne Forschungsaufgaben meldete. METR sagt, Fähigkeiten seien immer schwerer zu messen, was für Risikoargumente mit klaren Grenzen wichtig ist.
Die wichtigsten Fakten
- Umfasst öffentliche Modelle bis Opus 5.5 und GPT-6 Astra
- Verdopplungszeit TH1.1 und TH2 kombiniert: etwa 3,6 Monate
- Modelle erreichen oder übertreffen meist qualifizierte Menschen bei Code und Optimierung
- Agenten urteilen ohne klares Feedback schlechter als Experten
- Veröffentlicht am 20. November 2026