METR halla que el horizonte temporal de la IA de frontera se duplica cada 3,6 meses en tareas más difíciles
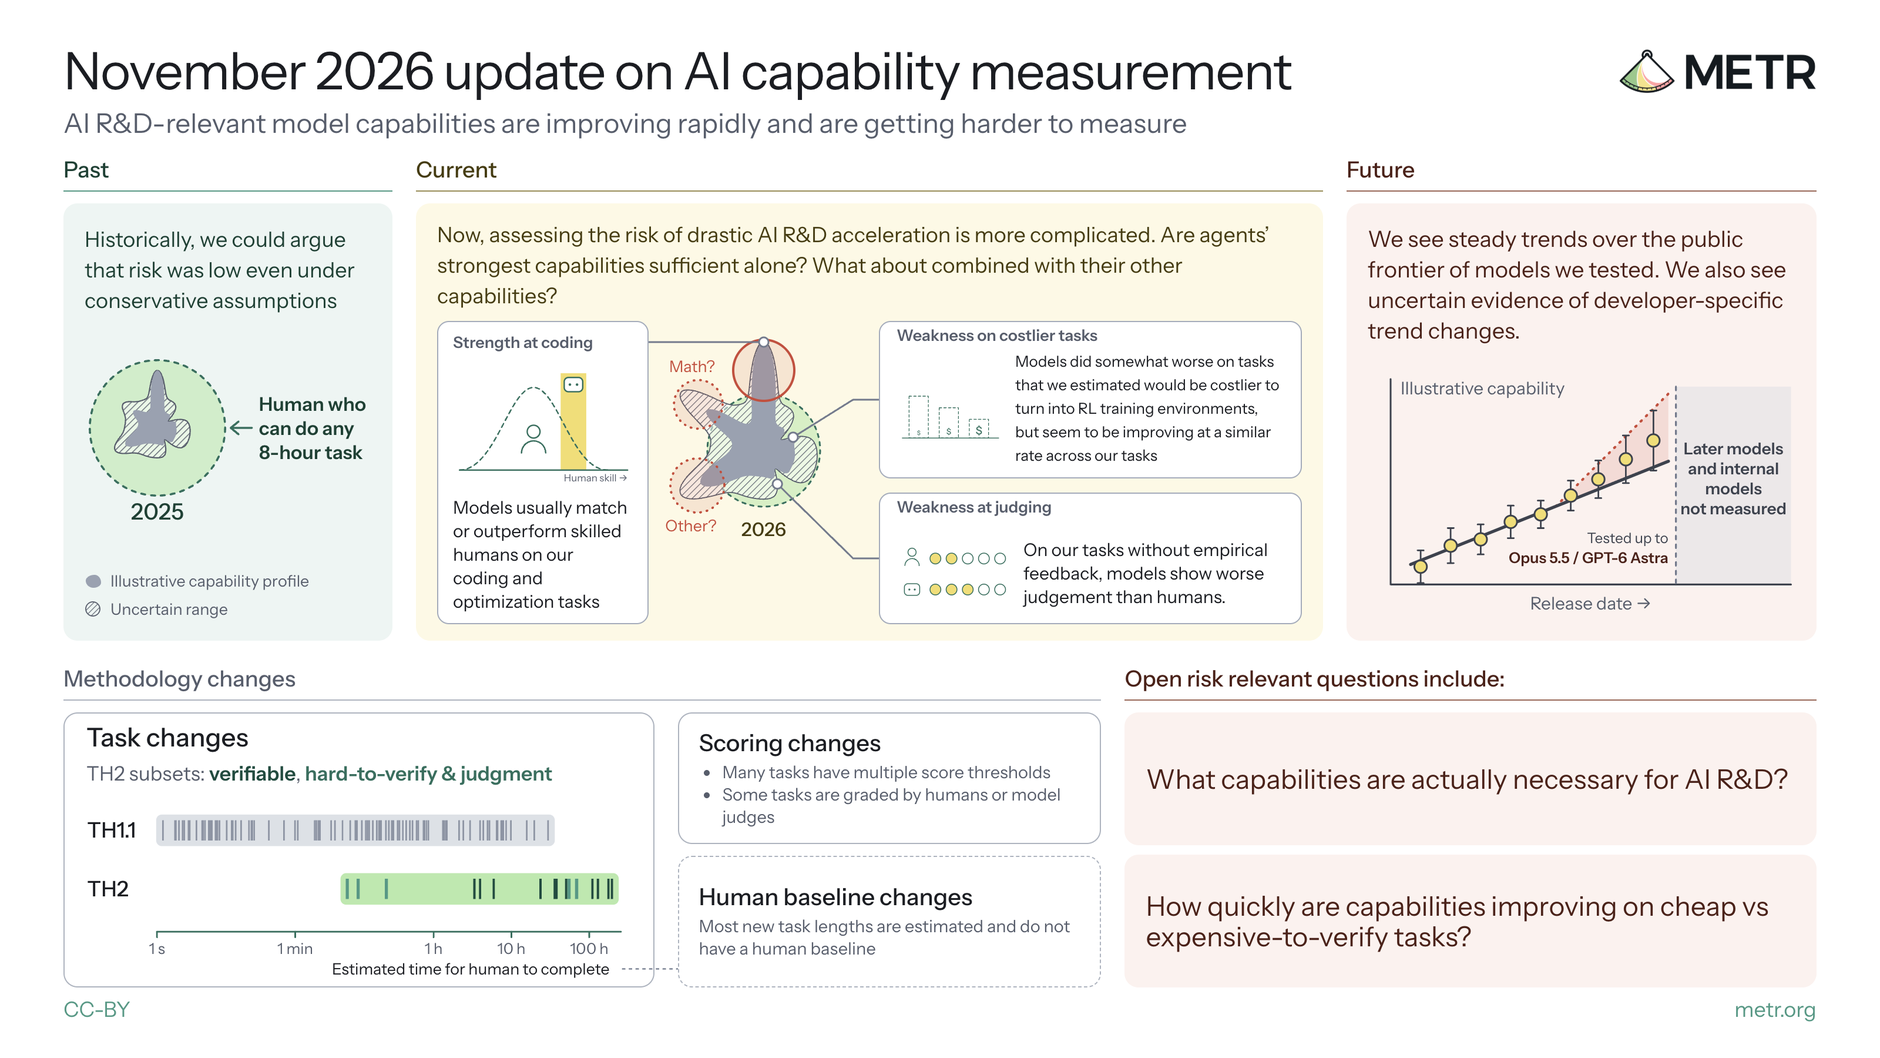
Su actualización del cuarto trimestre, con modelos hasta Opus 5.5 y GPT-6 Astra, dice que los agentes igualan o superan a humanos expertos en programación y optimización, pero juzgan peor que los expertos cuando la retroalimentación es poco clara, y que la evidencia pública no descarta una aceleración drástica de la I+D en IA en un par de años.
Por qué importa
El gráfico de horizonte temporal de METR es una de las medidas más citadas del progreso de la IA; esta actualización añade un conjunto más difícil, TH2, con tareas más ambiguas y de criterio, más cercanas a la investigación en IA. MIT Technology Review señala que ninguna evaluación diseñada por los modelos para METR fue considerada útil por su personal. El tiempo de duplicación es similar a una tendencia que OpenAI reportó en tareas internas. METR dice que medir capacidades es cada vez más difícil.
Datos clave
- Abarca modelos públicos hasta Opus 5.5 y GPT-6 Astra
- Duplicación en TH1.1 y TH2 combinados: unos 3,6 meses
- Los modelos suelen igualar o superar a humanos expertos en programación y optimización
- Los agentes juzgan peor que los expertos sin retroalimentación clara
- Publicado el 20 de noviembre de 2026