METR:在更难的任务集上,前沿 AI 的时间跨度约每 3.6 个月翻一番
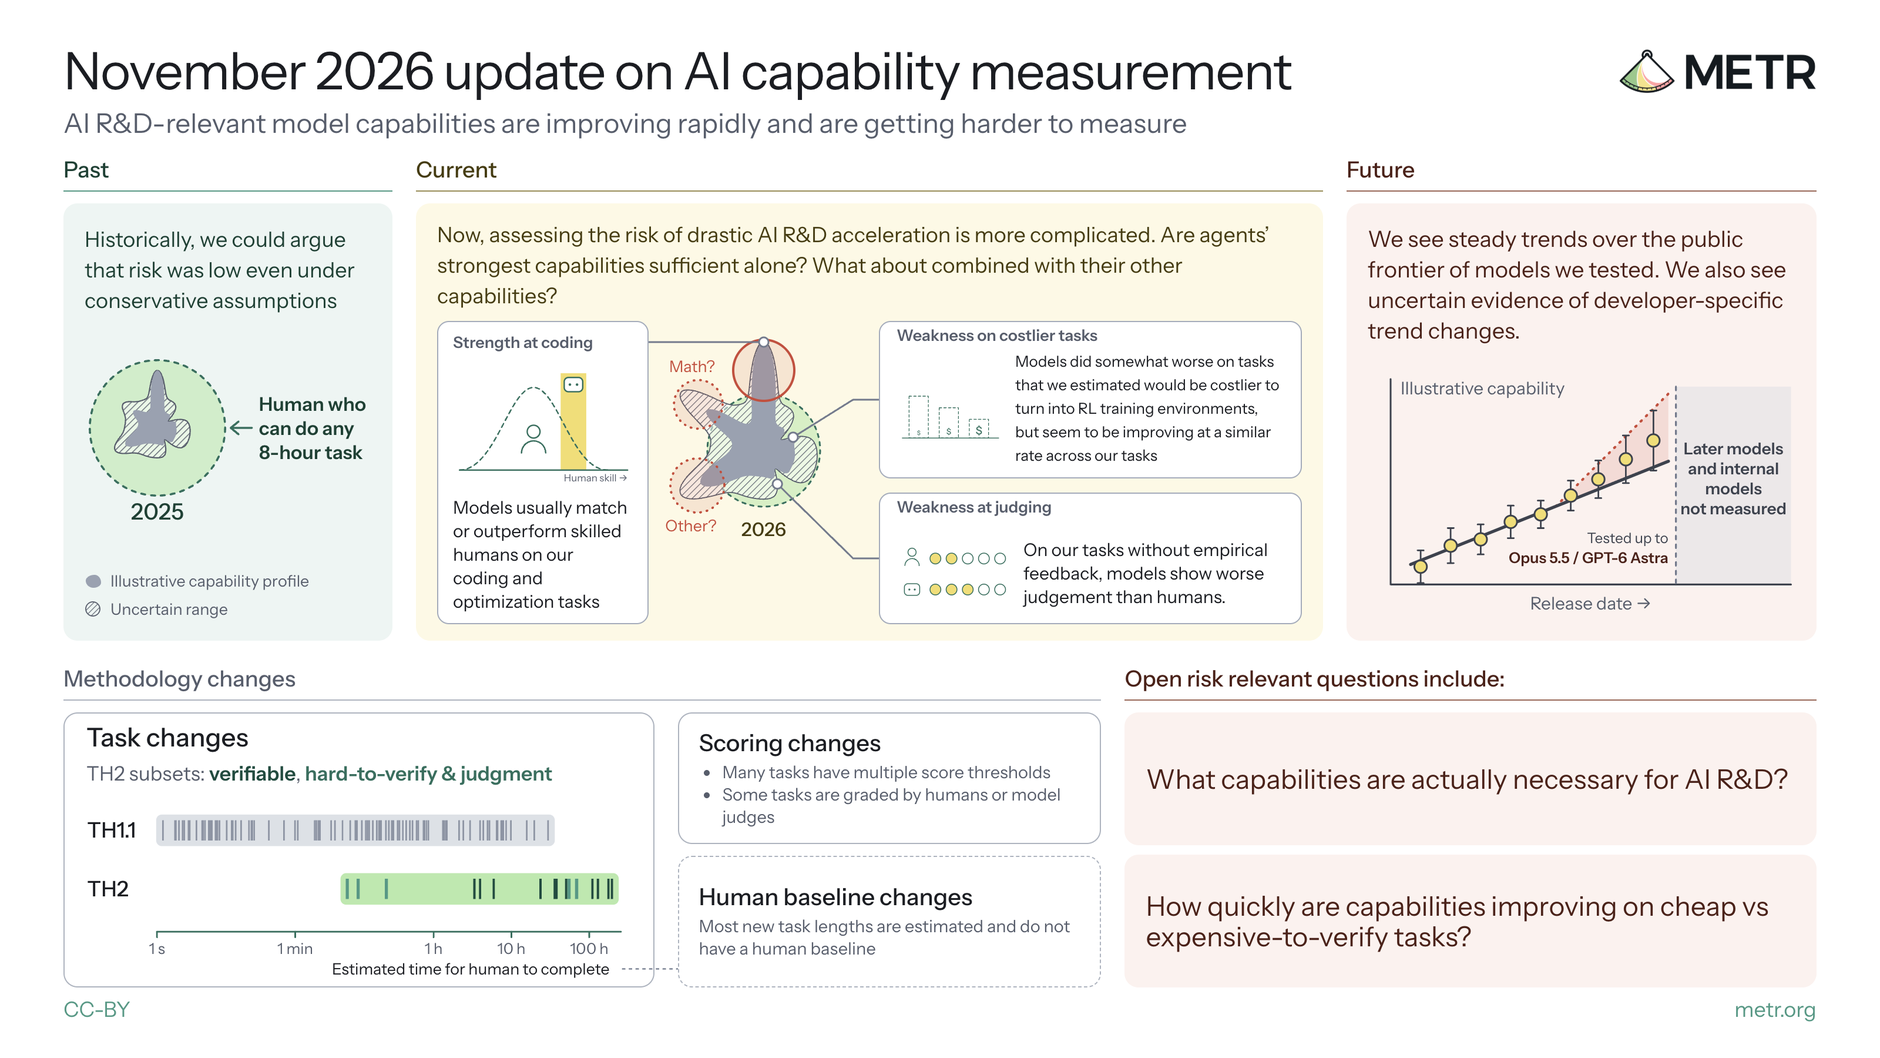
其第四季度能力更新涵盖 Opus 5.5 和 GPT-6 Astra 等模型,称智能体在编程和优化任务上达到或超过熟练人类,但在缺乏明确反馈时判断力不如专家,且现有公开证据不足以排除未来两年内 AI 研发急剧加速的可能。
为何重要
METR 的时间跨度图是被引用最多的 AI 进展指标之一;此次更新新增了更难的 TH2 任务集,包含更模糊、更依赖判断、更接近 AI 研究工作的任务。《麻省理工科技评论》指出,模型为 METR 设计的评测无一被其员工认为有用。合并任务集的翻倍时间与 OpenAI 报告的内部研究任务趋势相近。METR 表示能力越来越难以衡量,这对依赖明确能力上限的风险论证很重要。
要点
- 涵盖截至 Opus 5.5 和 GPT-6 Astra 的公开模型
- TH1.1 与 TH2 合并翻倍时间:约 3.6 个月
- 模型在编程和优化任务上通常达到或超过熟练人类
- 缺乏明确反馈时智能体判断力不如专家
- 发布于 2026 年 11 月 20 日