METR conclui que o horizonte temporal da IA de fronteira dobra a cada 3,6 meses em tarefas mais difíceis
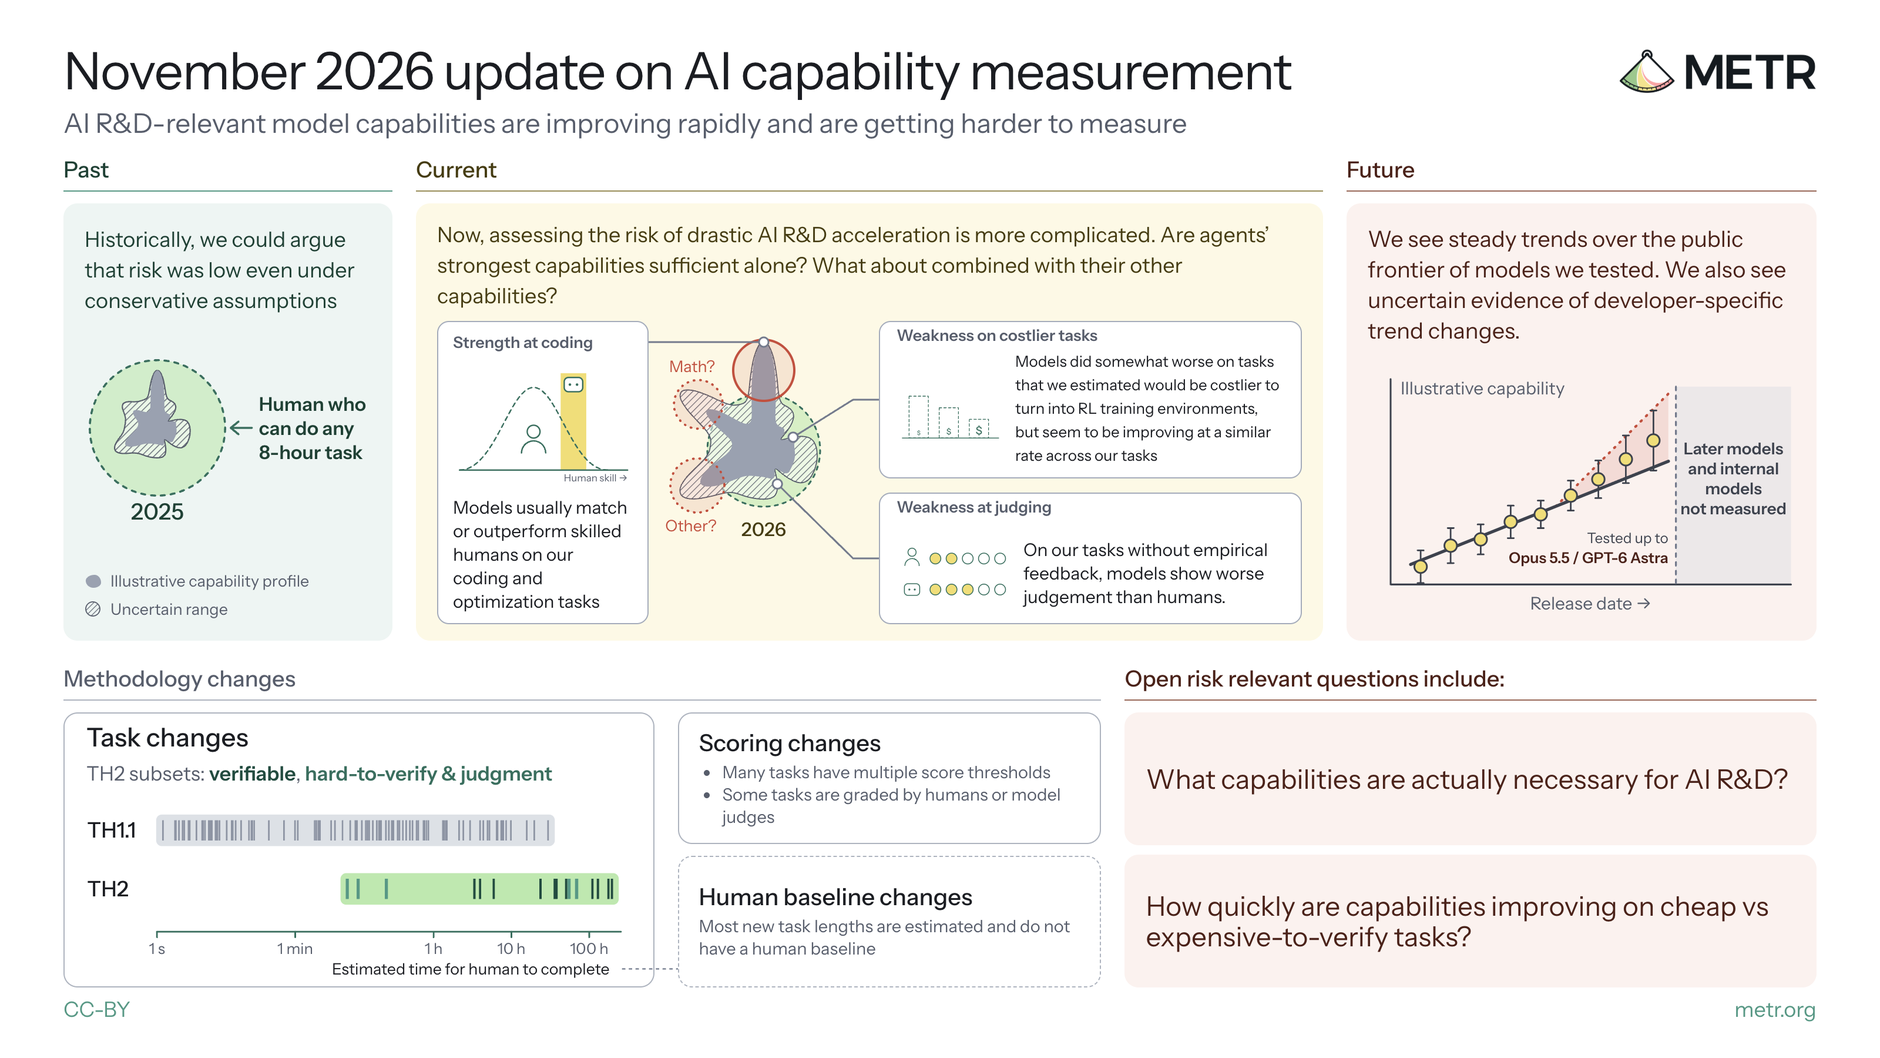
A atualização do quarto trimestre, com modelos até Opus 5.5 e GPT-6 Astra, diz que agentes igualam ou superam humanos qualificados em programação e otimização, mas julgam pior que especialistas sem feedback claro, e que a evidência pública não descarta uma aceleração drástica da P&D em IA nos próximos dois anos.
Por que importa
O gráfico de horizonte temporal da METR é uma das medidas mais citadas do progresso da IA; esta atualização acrescenta um conjunto mais difícil, o TH2, com tarefas mais vagas e de julgamento, mais próximas da pesquisa em IA. A MIT Technology Review observa que nenhuma avaliação criada pelos modelos para a METR foi considerada útil por sua equipe. O tempo de duplicação é parecido com uma tendência relatada pela OpenAI em tarefas internas. A METR diz que medir capacidades está cada vez mais difícil.
Fatos principais
- Abrange modelos públicos até Opus 5.5 e GPT-6 Astra
- Duplicação em TH1.1 e TH2 combinados: cerca de 3,6 meses
- Modelos costumam igualar ou superar humanos qualificados em programação e otimização
- Agentes julgam pior que especialistas sem feedback claro
- Publicado em 20 de novembro de 2026