إي تي إتش زيورخ وبيركلي: التدريب اللاحق بالتعلم المعزز على 144 مهمة يحسّن سياسة روبوت عامة في مشاهد وأجسام غير مرئية
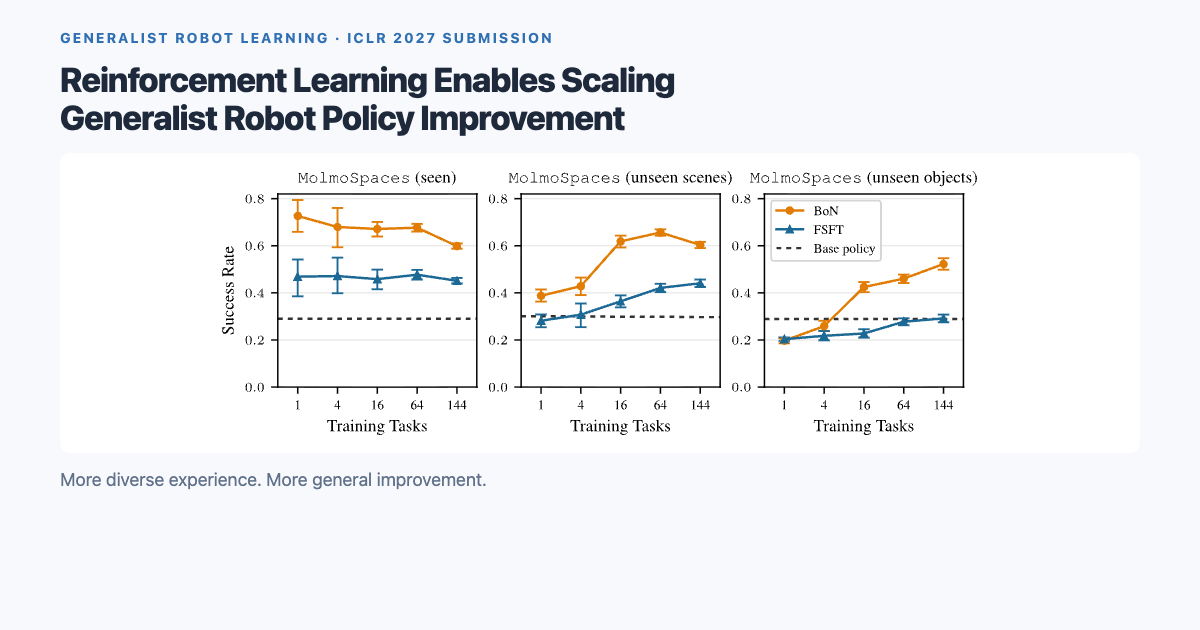
في محاكي MolmoSpaces، تحقق الطرق الموجهة بالناقد (BoN وOGPO) مكاسب تصل إلى 58 نقطة مئوية في المشاهد غير المرئية و39 في الأجسام غير المرئية مقارنة بالسياسة الأساسية، بينما أضرّ التدريب اللاحق على مهمة واحدة بالمهام الأخرى. والورقة مقدَّمة إلى ICLR 2027.
لماذا يهم
عادةً ما يحسّن التدريب اللاحق لسياسة روبوت عامة على مهمة واحدة الأداء فيها ويضعفه في غيرها. تغيّر هذه الدراسة عدد مهام التدريب من 1 إلى 144 وتجد أن التعلم المعزز الموجَّه بالناقد ينتقل من النسيان إلى التعميم مع زيادة التنوع. ويفيد تنوع المشاهد في المشاهد الجديدة وتنوع الأجسام في الأجسام الجديدة، وأقوى انتقال يحدث حين تشبه فئات الأجسام المضافة الفئات غير المرئية. وكل النتائج من المحاكاة، والورقة مقدَّمة إلى ICLR 2027 ولم تخضع بعد لمراجعة الأقران. ويُراقَب إجراء اختبارات على روبوتات حقيقية ونشر شيفرة طريقة OGPO.
حقائق رئيسية
- توسيع التدريب اللاحق من 1 إلى 144 مهمة تدريب في MolmoSpaces
- الطرق الموجهة بالناقد: BoN وOGPO؛ كما اختُبر الضبط الدقيق الخاضع للإشراف المرشَّح (FSFT)
- مكاسب فوق السياسة الأساسية تصل إلى +58 نقطة مئوية في المشاهد غير المرئية و+39 في الأجسام غير المرئية
- أضرّ التدريب اللاحق على مهمة واحدة بالأداء في المهام الأخرى
- مؤلفون من إي تي إتش زيورخ وجامعة كاليفورنيا بيركلي وCMU وTUM ومعهد ماكس بلانك للأنظمة الذكية وجامعة وارسو وNomagic
- موسومة بأنها مقدَّمة إلى ICLR 2027