苏黎世联邦理工与伯克利团队:在 144 项任务上做强化学习后训练,可提升通用机器人策略在未见场景和物体上的表现
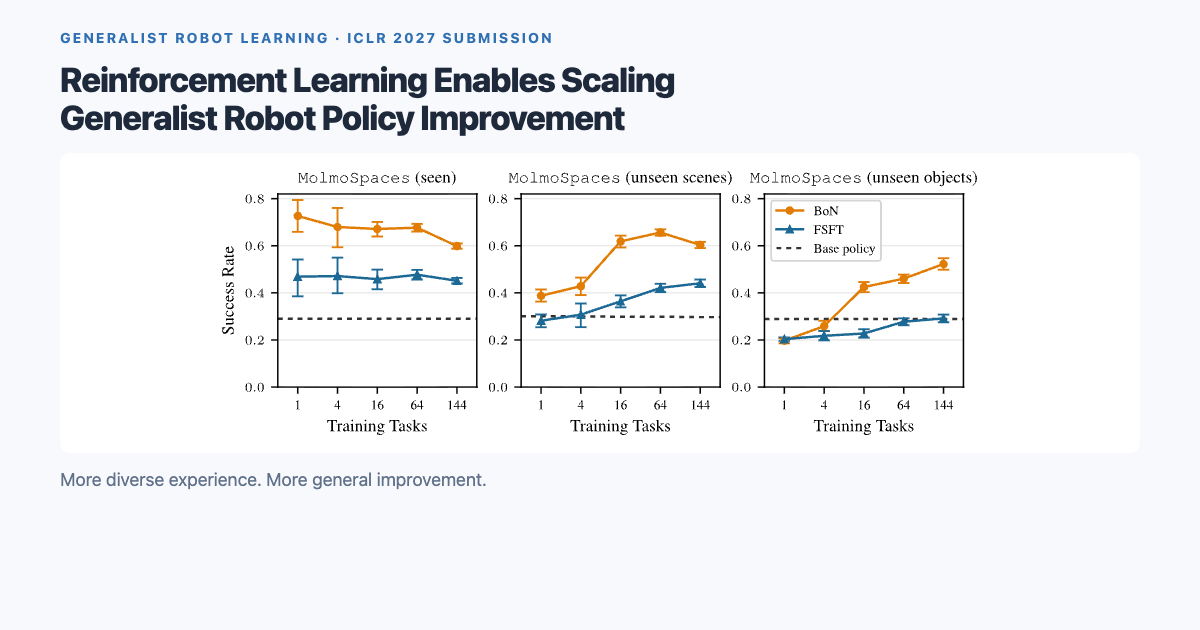
在 MolmoSpaces 模拟器中,由评论器引导的方法(BoN、OGPO)相对基础策略,在未见场景上最多提升 58 个百分点,在未见物体上最多提升 39 个百分点;而单任务后训练会损害其他任务。论文为 ICLR 2027 投稿。
为何重要
在单一任务上对通用机器人策略做后训练,通常会让它在该任务上变好、在其他任务上变差。这项研究把训练任务数从 1 增加到 144,发现随着多样性增加,由评论器引导的强化学习从“遗忘”转向“泛化”。场景多样性有助于新场景,物体多样性有助于新物体;当新增物体类别与未见物体相似时迁移最强。所有结果均来自模拟,论文为 ICLR 2027 投稿,尚未经同行评审。后续可关注真实机器人测试,以及 OGPO 方法代码的发布。
要点
- 在 MolmoSpaces 中将后训练任务数从 1 扩展到 144
- 评论器引导方法:BoN 与 OGPO;也测试了过滤式监督微调(FSFT)
- 相对基础策略,未见场景最多提升 58 个百分点,未见物体最多提升 39 个百分点
- 单任务后训练会降低其他任务的表现
- 作者来自苏黎世联邦理工、加州大学伯克利分校、CMU、慕尼黑工大、马普智能系统研究所、华沙大学和 Nomagic
- 标注为 ICLR 2027 投稿