L'ETH Zurich et Berkeley montrent qu'un post-entraînement par RL sur 144 tâches améliore une politique robotique généraliste sur des scènes et objets inédits
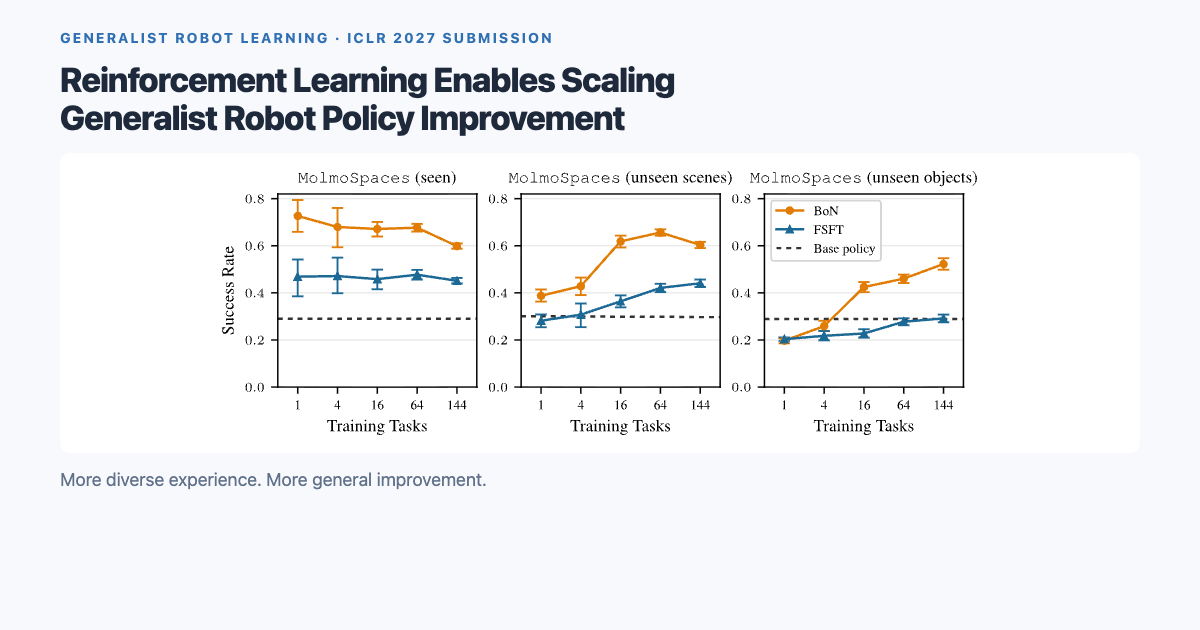
Dans le simulateur MolmoSpaces, les méthodes guidées par critique (BoN, OGPO) gagnent jusqu'à 58 points de pourcentage sur des scènes inédites et 39 sur des objets inédits par rapport à la politique de base ; le post-entraînement sur une seule tâche dégradait les autres. L'article est soumis à ICLR 2027.
Pourquoi c’est important
Post-entraîner une politique robotique généraliste sur une seule tâche l'améliore en général là mais la dégrade ailleurs. Cette étude fait varier le nombre de tâches d'entraînement de 1 à 144 et constate que l'apprentissage par renforcement guidé par critique passe de l'oubli à la généralisation quand la diversité croît. La diversité des scènes aide pour de nouvelles scènes et celle des objets pour de nouveaux objets, avec le meilleur transfert quand les catégories ajoutées ressemblent aux catégories inédites. Tous les résultats sont en simulation et l'article est soumis à ICLR 2027, sans relecture par les pairs à ce stade. À suivre : des essais sur robots réels et la publication du code de la méthode OGPO.
Faits clés
- Post-entraînement passé de 1 à 144 tâches d'entraînement dans MolmoSpaces
- Méthodes guidées par critique : BoN et OGPO ; le fine-tuning supervisé filtré (FSFT) a aussi été testé
- Gains par rapport à la politique de base jusqu'à +58 pp sur des scènes inédites et +39 pp sur des objets inédits
- Le post-entraînement sur une seule tâche dégradait les autres tâches
- Auteurs de l'ETH Zurich, UC Berkeley, CMU, TUM, de l'Institut Max-Planck pour les systèmes intelligents, de l'Université de Varsovie et de Nomagic
- Indiqué comme soumission à ICLR 2027