ETHチューリッヒとバークレー:144タスクでのRL事後学習が汎用ロボット方策を未知のシーン・物体で改善
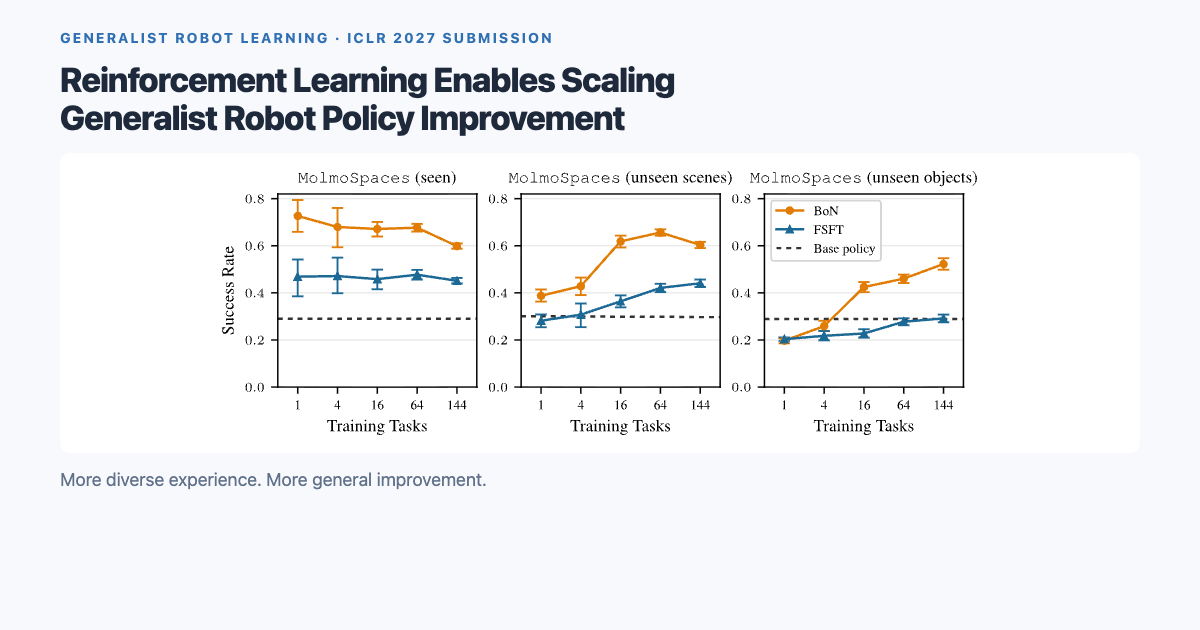
MolmoSpacesシミュレータで、批評器誘導の手法(BoN、OGPO)はベース方策に対し、未知のシーンで最大58ポイント、未知の物体で最大39ポイント向上。単一タスクの事後学習は他タスクを劣化させた。論文はICLR 2027投稿。
なぜ重要か
汎用ロボット方策を単一タスクで事後学習すると、そのタスクは向上するが他では悪化しやすい。本研究は訓練タスク数を1から144まで変え、批評器誘導の強化学習が、多様性の増加とともに「忘却」から「汎化」へ移ることを示した。シーンの多様性は新しいシーンに、物体の多様性は新しい物体に効き、追加した物体カテゴリが未知の物体に似ているほど転移が強い。結果はすべてシミュレーションで、論文はICLR 2027への投稿であり査読前だ。実機での検証と、OGPO手法のコード公開が注目点となる。
要点
- MolmoSpacesで事後学習のタスク数を1から144へ拡大
- 批評器誘導の手法:BoNとOGPO。フィルタ付き教師ありファインチューニング(FSFT)も検証
- ベース方策比で未知のシーンは最大+58ポイント、未知の物体は最大+39ポイント
- 単一タスクの事後学習は他タスクの性能を低下させた
- 著者はETHチューリッヒ、UCバークレー、CMU、TUM、マックス・プランク知能システム研究所、ワルシャワ大学、Nomagic
- ICLR 2027投稿と明記