ETH Zürich und Berkeley zeigen: RL-Nachtraining auf 144 Aufgaben verbessert eine generalistische Roboterpolitik bei unbekannten Szenen und Objekten
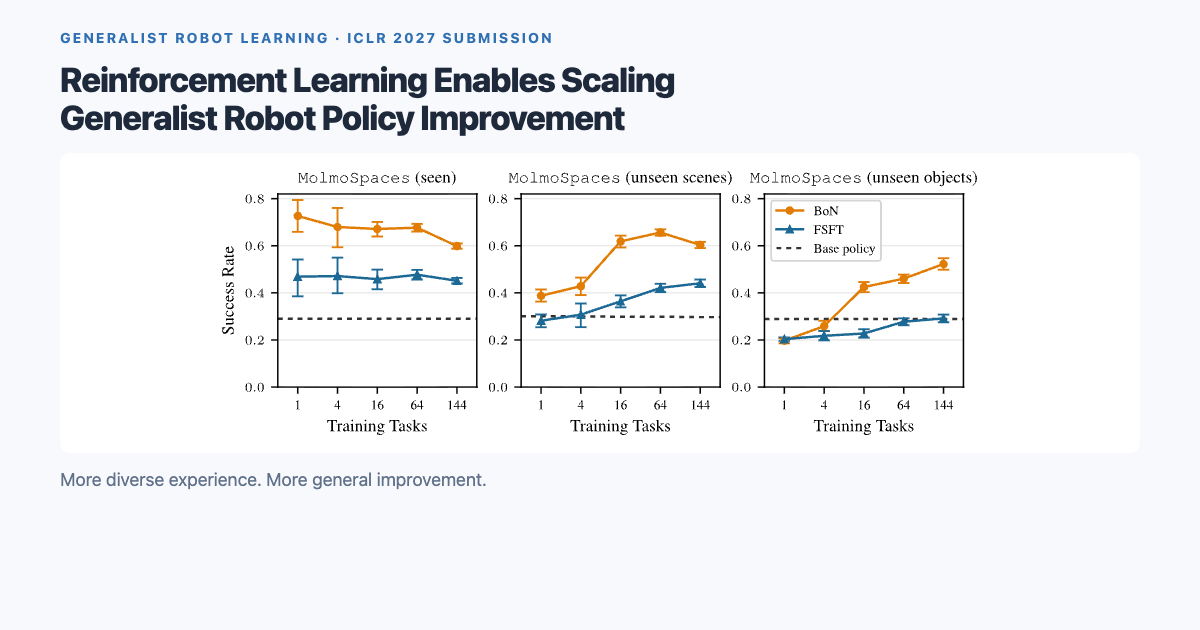
Im Simulator MolmoSpaces gewinnen Critic-geführte Methoden (BoN, OGPO) gegenüber der Basispolitik bis zu 58 Prozentpunkte bei unbekannten Szenen und 39 bei unbekannten Objekten; Nachtraining auf einer einzelnen Aufgabe verschlechterte andere Aufgaben. Das Paper ist eine Einreichung für ICLR 2027.
Warum es wichtig ist
Das Nachtraining einer generalistischen Roboterpolitik auf einer einzelnen Aufgabe macht sie dort meist besser und anderswo schlechter. Die Studie variiert die Zahl der Trainingsaufgaben von 1 bis 144 und stellt fest, dass Critic-geführtes Reinforcement Learning mit wachsender Vielfalt vom Vergessen zur Generalisierung übergeht. Szenenvielfalt hilft bei neuen Szenen, Objektvielfalt bei neuen Objekten; am stärksten ist der Transfer, wenn hinzugefügte Objektkategorien unbekannten ähneln. Alle Ergebnisse stammen aus der Simulation, das Paper ist eine ICLR-2027-Einreichung und noch nicht begutachtet. Zu beobachten sind Tests mit echten Robotern und die Veröffentlichung des Codes der OGPO-Methode.
Die wichtigsten Fakten
- Nachtraining von 1 auf 144 Trainingsaufgaben in MolmoSpaces hochskaliert
- Critic-geführte Methoden: BoN und OGPO; gefiltertes überwachtes Fine-Tuning (FSFT) ebenfalls getestet
- Gewinne gegenüber der Basispolitik bis zu +58 PP bei unbekannten Szenen und +39 PP bei unbekannten Objekten
- Nachtraining auf einer einzelnen Aufgabe verschlechterte andere Aufgaben
- Autoren von ETH Zürich, UC Berkeley, CMU, TUM, Max-Planck-Institut für Intelligente Systeme, Universität Warschau und Nomagic
- Als Einreichung für ICLR 2027 gekennzeichnet