ETH Zúrich y Berkeley muestran que el posentrenamiento con RL en 144 tareas mejora una política robótica generalista en escenas y objetos no vistos
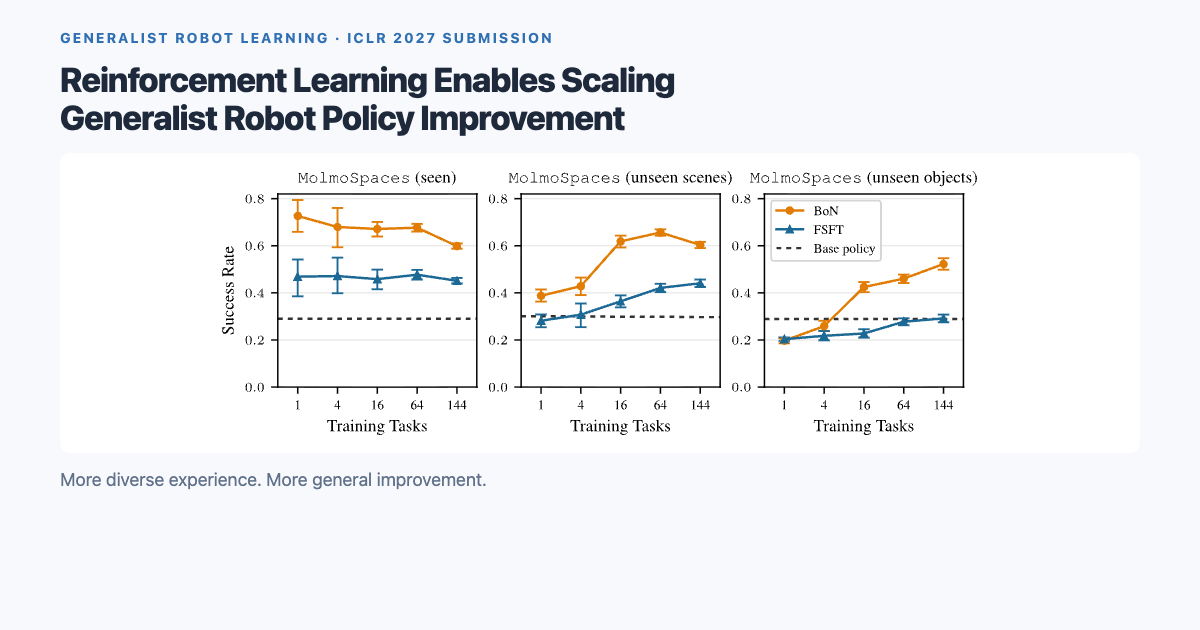
En el simulador MolmoSpaces, los métodos guiados por crítico (BoN, OGPO) ganan hasta 58 puntos porcentuales en escenas no vistas y 39 en objetos no vistos frente a la política base; el posentrenamiento en una sola tarea degradaba las demás. El artículo es una propuesta para ICLR 2027.
Por qué importa
El posentrenamiento de una política robótica generalista en una sola tarea suele mejorarla ahí y empeorarla en el resto. Este estudio varía el número de tareas de entrenamiento de 1 a 144 y halla que el aprendizaje por refuerzo guiado por crítico pasa del olvido a la generalización a medida que crece la diversidad. La diversidad de escenas ayuda con escenas nuevas y la de objetos con objetos nuevos, con la mayor transferencia cuando las categorías añadidas se parecen a las no vistas. Todos los resultados son en simulación y el artículo es una propuesta a ICLR 2027, aún sin revisión por pares. Conviene vigilar las pruebas con robots reales y la publicación del código del método OGPO.
Datos clave
- Posentrenamiento escalado de 1 a 144 tareas de entrenamiento en MolmoSpaces
- Métodos guiados por crítico: BoN y OGPO; también se probó el ajuste fino supervisado filtrado (FSFT)
- Mejoras sobre la política base de hasta +58 pp en escenas no vistas y +39 pp en objetos no vistos
- El posentrenamiento en una sola tarea degradó el rendimiento en otras tareas
- Autores de ETH Zúrich, UC Berkeley, CMU, TUM, Instituto Max Planck de Sistemas Inteligentes, Universidad de Varsovia y Nomagic
- Presentado como propuesta a ICLR 2027