ETH Zurique e Berkeley mostram que pós-treinamento com RL em 144 tarefas melhora uma política robótica generalista em cenas e objetos inéditos
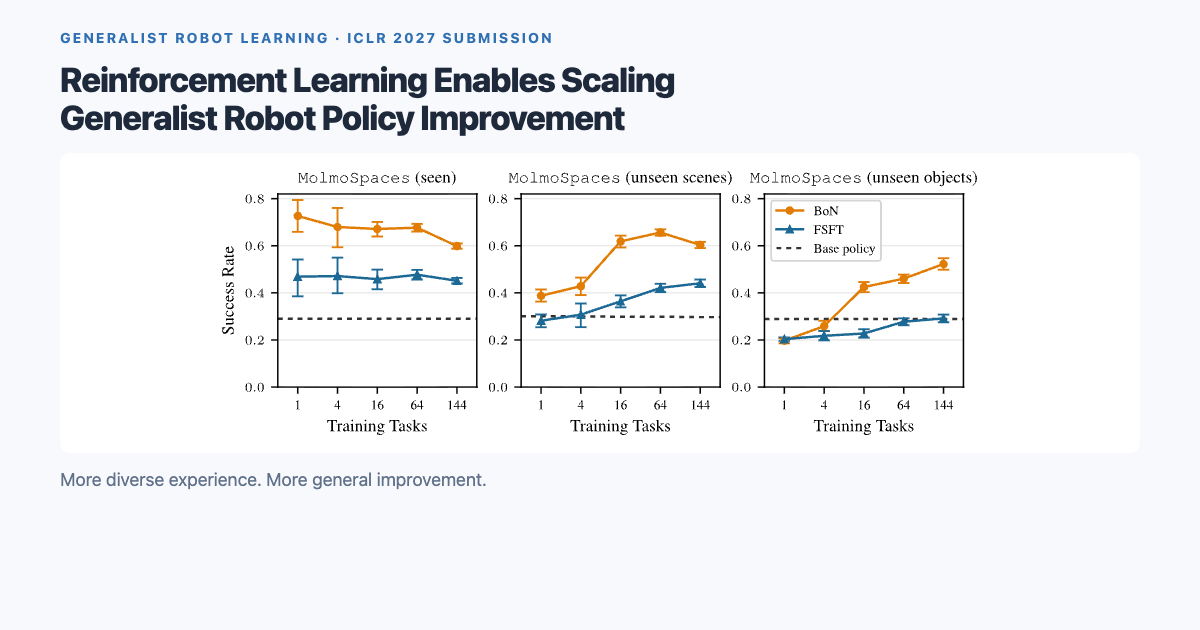
No simulador MolmoSpaces, métodos guiados por crítico (BoN, OGPO) ganham até 58 pontos percentuais em cenas inéditas e 39 em objetos inéditos sobre a política base; o pós-treinamento em uma só tarefa degradava as outras. O artigo é uma submissão ao ICLR 2027.
Por que importa
O pós-treinamento de uma política robótica generalista em uma só tarefa costuma melhorá-la ali e piorá-la no resto. Este estudo varia o número de tarefas de treino de 1 a 144 e constata que o aprendizado por reforço guiado por crítico passa do esquecimento à generalização à medida que a diversidade cresce. A diversidade de cenas ajuda em cenas novas e a de objetos em objetos novos, com maior transferência quando as categorias adicionadas se parecem com as inéditas. Todos os resultados são em simulação e o artigo é uma submissão ao ICLR 2027, ainda sem revisão por pares. Vale acompanhar testes em robôs reais e a liberação do código do método OGPO.
Fatos principais
- Pós-treinamento escalado de 1 a 144 tarefas de treino no MolmoSpaces
- Métodos guiados por crítico: BoN e OGPO; o ajuste fino supervisionado filtrado (FSFT) também foi testado
- Ganhos sobre a política base de até +58 pp em cenas inéditas e +39 pp em objetos inéditos
- O pós-treinamento em uma só tarefa degradou o desempenho em outras tarefas
- Autores da ETH Zurique, UC Berkeley, CMU, TUM, Instituto Max Planck de Sistemas Inteligentes, Universidade de Varsóvia e Nomagic
- Indicado como submissão ao ICLR 2027